
Nvidia, Vera Rubin'lerde megawat başına yüzde 40 verimlilik artışı sağladı
Nvidia, Vera Rubin platformu ve DSX MaxLPS yazılımıyla veri merkezlerinde megavat başına işlenen token miktarını artırmayı hedefliyor. Yeni mimari, yapay zeka altyapılarında ham işlem gücünün yanı sıra enerji verimliliğini de temel performans ölçütlerinden biri haline getiriyor.
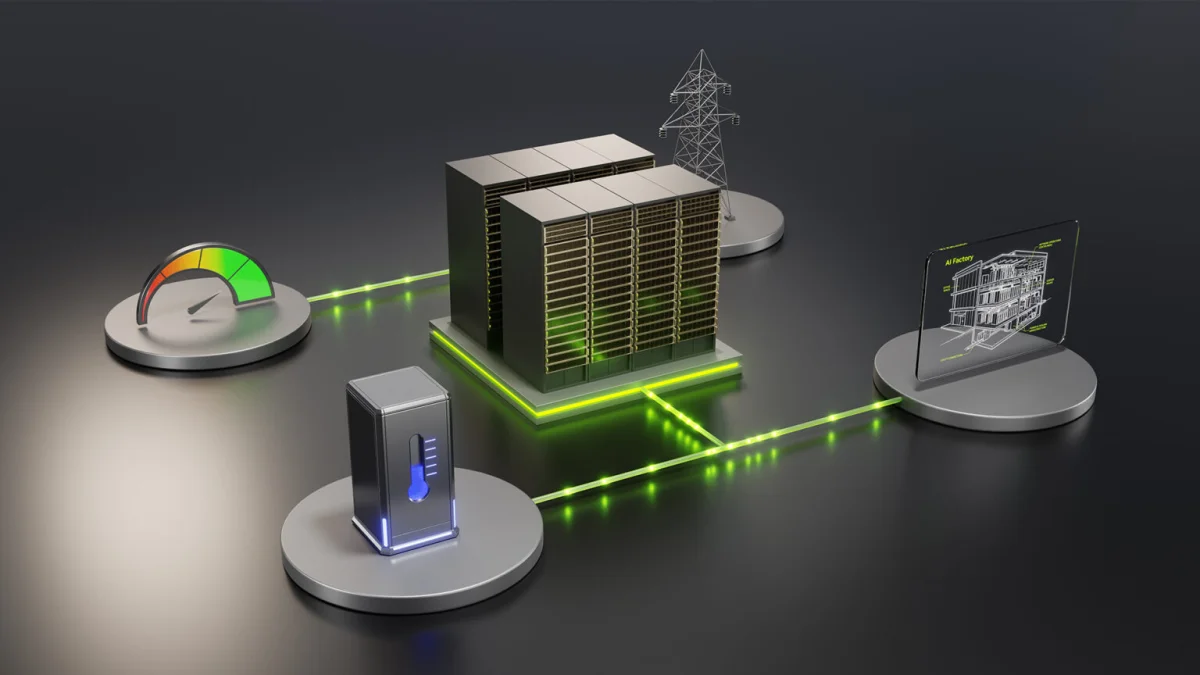
Yapay zeka modellerinin büyüyen işlem ihtiyacı veri merkezlerinin elektrik tüketimini artırırken Nvidia, donanımdan yazılıma ve şebeke yönetimine uzanan yeni bir yapay zeka fabrikası yaklaşımı geliştiriyor. Vera Rubin sistemlerini Dynamo çıkarım yazılımı, NeMo kütüphaneleri, NVLink bağlantıları ve BlueField DPU destekli ağ altyapısıyla birleştiren şirket, aynı enerji bütçesi içinde daha fazla yapay zeka iş yükünün çalıştırılmasına odaklanıyor. Bu yaklaşımda temel ölçüt, yalnızca ulaşılan FLOPS seviyesi değil, bir megavat elektrik karşılığında üretilebilen token miktarı.
ŞEBEKE UYUMU
Nvidia’nın DSX MaxLPS teknolojisi, şirketin verilerine göre megavat başına yüzde 40’a varan oranda daha yüksek token işleme kapasitesi sağlayabiliyor. DSX Flex yazılımı ise Emerald AI ve Conductor platformlarında veri merkezlerinin elektrik tüketimini şebekedeki değişimlere göre dinamik biçimde ayarlıyor. Sistem, elektrik arzının daraldığı dönemlerde farklı iş yüklerinin güç kullanımını yeniden düzenleyerek kritik işlemlerin devam etmesini amaçlıyor. Böylece yapay zeka altyapısının yalnızca hesaplama performansına değil, elektrik şebekesinin mevcut kapasitesine göre de yönetilebildiği bir yapı oluşturuluyor.
SABİT GÜÇ BÜTÇESİ
Bulut altyapı sağlayıcısı Lambda tarafından gerçekleştirilen testler, mevcut elektrik kapasitesi değiştirilmeden daha fazla işlem gücünün kullanılabileceğini gösterdi. Beş kabin ve 19 düğümden oluşan bir kümede yapılan uygulamada şirket, normal şartlarda tam güçte 16 düğümün çalışabileceği enerji bütçesi içinde 19 düğümü aynı anda devreye aldı. Kümenin token işleme kapasitesi saniyede 4 milyondan 5 milyona yükseldi. Bu, toplam token çıktısında yüzde 24, Watt başına performansta ise yüzde 23 artış anlamına geldi.
DAHA FAZLA GPU
Aynı yaklaşım Vera Rubin ve Groq 3 LPX raflarında da tesisin mevcut elektrik sınırları içinde daha fazla hızlandırıcının çalıştırılmasına odaklanıyor. Nvidia’nın aktardığı verilere göre aynı güç bütçesi altında yüzde 40’a kadar daha fazla GPU kullanılabiliyor. Böylece yeni elektrik hatları veya ek güç altyapısı kurulmadan mevcut veri merkezi kapasitesinden daha yüksek hesaplama çıktısı alınması hedefleniyor. Bu model, özellikle elektrik bağlantısının yeni sunucu kurulumlarının önündeki temel sınırlamalardan biri haline geldiği yapay zeka veri merkezlerinde kapasite planlamasını doğrudan etkiliyor.
VERA PERFORMANSI
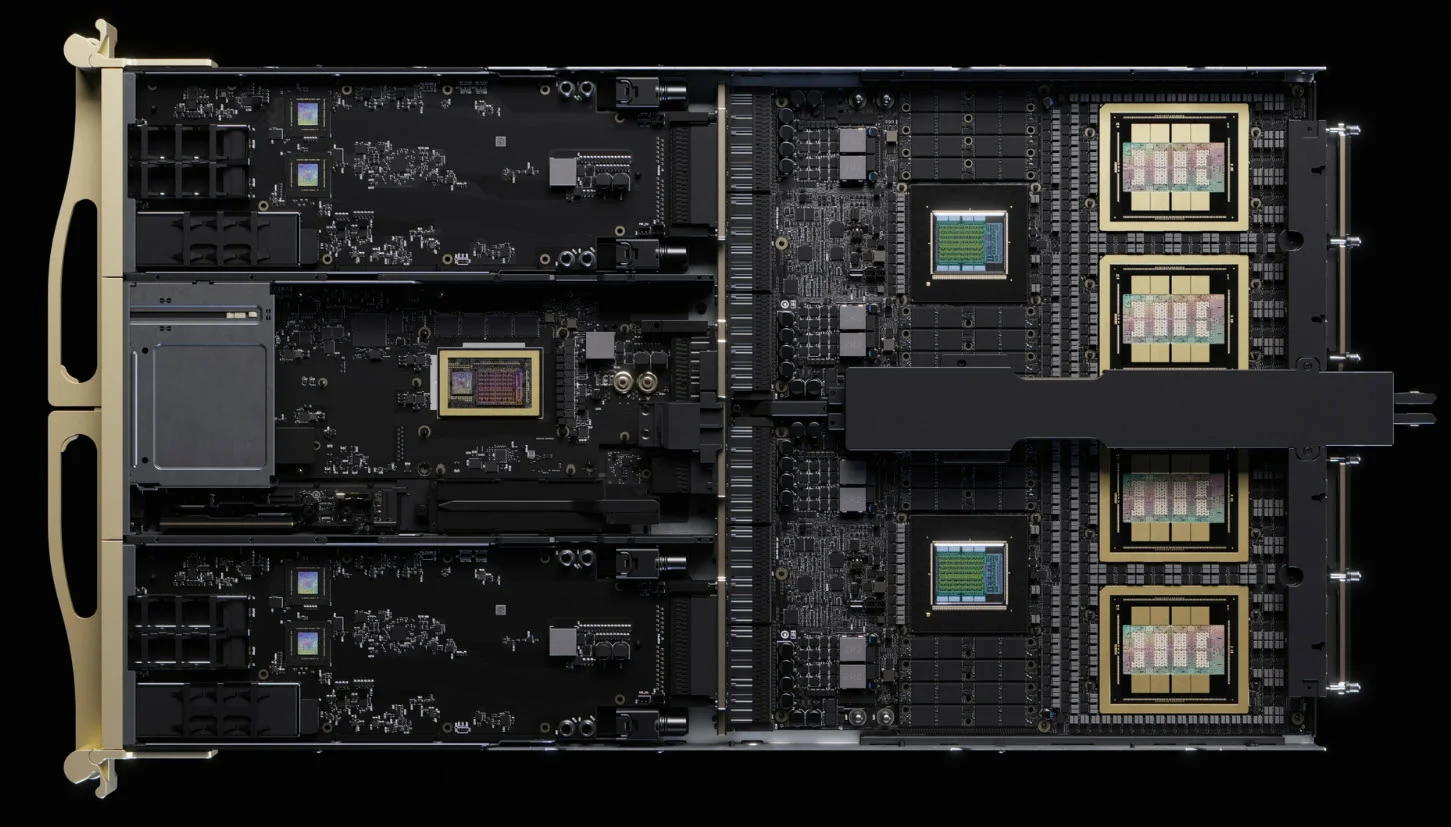
Nvidia’nın Vera işlemcisi de farklı yapay zeka ve veri işleme platformlarında test ediliyor. Perplexity’nin otonom yapay zeka uygulamaları için geliştirdiği SPACE sanal alanında Vera’nın başlatma sürelerini 1,9 kat hızlandırdığı belirtiliyor. ClickHouse veritabanı testlerinde ise işlemcinin ölçülen en yüksek performansa ulaştığı aktarılıyor. DeepInfra testlerinde orkestrasyon gecikmesi 2,2 kat azalırken, Redpanda uygulamalarında 5,5 kat daha düşük gecikme ve yüzde 73 daha yüksek işleme kapasitesi elde edildi.
ANALİTİK İŞ YÜKLERİ
Vera’nın performans artışı yalnızca yapay zeka ajanlarıyla sınırlı kalmıyor. Starburst ve Kinetica analitik sorgularında 3 kata varan hızlanma kaydedildiği belirtiliyor. Bu sonuçlar, veri tabanı sorguları, otonom ajan orkestrasyonu ve yüksek hacimli veri akışlarının aynı altyapı üzerinde daha düşük gecikmeyle yürütülmesine yönelik çalışmaları destekliyor. Nvidia, işlemci, hızlandırıcı, ağ ve yazılım katmanlarını birlikte optimize ederek veri merkezlerinin enerji tüketimi ile hesaplama çıktısı arasındaki oranı yükseltmeye çalışıyor.
YENİ VERİMLİLİK ÖLÇÜTÜ
Nvidia’nın yaklaşımı, yapay zeka veri merkezlerinde performans ölçümünü yalnızca en yüksek hesaplama gücünden megavat başına üretilen token miktarına doğru genişletiyor. Annapurna’nın NVHBM çalışmaları, d-Matrix’in NVLink Fusion entegrasyonu ve Pinterest’in Blackwell tabanlı görsel yapay zeka uygulamaları da aynı enerji sınırları içinde daha fazla işlem yapılmasına yönelik örnekler arasında gösteriliyor. Vera Rubin NVL72 mimarisinin AgentX iş yüklerinde 30 kata varan kapasite artışı sağladığı, Groq 3 LPX platformunun ise düşük gecikmeli çıkarım performansına odaklandığı belirtiliyor. Nvidia, bu sistemleri aynı enerji bütçesi içinde daha fazla yapay zeka işlemi gerçekleştirebilen veri merkezi mimarisinin parçaları olarak konumlandırıyor.
Yorum yazmak için giriş yapın.
Henüz yorum yok. İlk yorumu siz yazın.