
DeepSeek V4.1 Flash, GPT-5.6 Sol ve Opus 5'ten 86 kat daha düşük maliyetli
DeepSeek, kodlama ve siber güvenlik testlerinde yüksek performans ve düşük işlem maliyeti hedefleyen V4.1 Flash modelini duyurdu. 718 milyar parametreli model, bellek kullanımını azaltan yeni mimarisi ve DRAM tabanlı Engram sistemiyle veri merkezi donanım ihtiyacını düşürmeye odaklanıyor.
Çinli yapay zeka geliştiricisi DeepSeek, V4.1 Flash adını verdiği yeni büyük dil modelini tanıttı. Şirketin açıkladığı teknik verilere göre model, Çok Modlu Uzmanlar Karması mimarisini 40 katmanlı Nedensel Kodlayıcı-Kod Çözücü yapısıyla birleştiriyor. Bellek ve işlem yükünü azaltmaya yönelik geliştirilen sistemde, yüksek bant genişlikli belleğin yanı sıra daha düşük maliyetli DRAM altyapısından da yararlanılıyor. DeepSeek, modelin özellikle kodlama, siber güvenlik ve uzun bağlamlı kurumsal iş yüklerinde yüksek performans sağlarken işlem maliyetlerini önemli ölçüde azaltabildiğini belirtiyor.
YENİ MİMARİ
V4.1 Flash’ın temelinde, tek bir paylaşılan süpervizör uzman tarafından yönetilen 384 yönlendirilmiş uzmandan oluşan MoE mimarisi bulunuyor. Sistem, her işlemde bütün modeli çalıştırmak yerine yalnızca ihtiyaç duyulan uzmanları devreye alarak hesaplama yükünü azaltıyor. Modelin 40 katmanlı Nedensel Kodlayıcı-Kod Çözücü yapısının ilk 20 katmanı, uzun istemleri işleyen kodlayıcı bölümünü oluşturuyor ve bu aşamada yaklaşık 8 milyar parametre etkinleştiriliyor. Yanıt üretiminden sorumlu sonraki 20 katmanlı kod çözücü bölümünde ise 16 milyar parametre devreye giriyor. İki aşama arasında oluşturulan KV önbelleğinin tek yönlü aktarılması, özellikle uzun girdilerin kullanıldığı kurumsal ve aracılı yapay zeka iş yüklerinde bellek kullanımını azaltmayı amaçlıyor.
BELLEK OPTİMİZASYONU
Modelin bellek tarafındaki temel yeniliklerini Sıkıştırılmış Seyrek Dikkat 2 ve SWA Sınırlı Yeniden Oynatma teknolojileri oluşturuyor. Lightning Indexer mekanizması, uzun bağlam içindeki en önemli bölümleri belirleyerek dikkat işlemlerinin bu alanlara yönlendirilmesini sağlıyor. CSA2 yapısında katmanlar tam mod, yeniden indeksleme ve yeniden kullanım görevlerine ayrılarak işlem yükü dağıtılıyor. Küresel dikkat durumu 1 milyon jetona kadar HBM üzerinde tutulurken, 128 jetonluk yerel pencereler SWA mekanizmasıyla yeniden işleniyor. DeepSeek’in açıkladığı verilere göre bu yapı, KV önbellek büyüklüğünü jeton başına 890 bayta kadar indiriyor. Böylece HBM gereksinimi 3,9 kat, SSD bağımlılığı ise 8 kat azaltılıyor.
YÜKSEK ÇIKARIM HIZI
V4.1 Flash’ta tek geçişli mHC otoyol hatları ile DSpark tahminci kod çözme algoritması da çıkarım sürecinin hızlandırılması için kullanılıyor. Bu mekanizmalar, uzun yanıtların üretilmesi sırasında ortaya çıkabilecek sonek bozulmalarını azaltmaya ve tahmin edilen sonraki jetonların daha hızlı işlenmesine odaklanıyor. DeepSeek’in verilerine göre model, uygun donanım koşullarında saniyede 120 jetona kadar çıkarım hızına ulaşabiliyor. Bellek kullanımındaki düşüş ile yüksek çıkarım hızının birlikte sağlanması, özellikle uzun bağlamlı ve yoğun istem trafiğine sahip sistemlerde donanım kullanımının azaltılmasını hedefliyor.
DRAM TABANLI BELLEK
Modelin toplam parametre sayısı 718 milyara ulaşırken, bunun 196 milyarlık bölümünü Engram adı verilen arama tablosu oluşturuyor. DeepSeek, bu büyük bilgi tablosunu maliyeti yüksek GPU belleğinde tutmak yerine DRAM üzerinde depoluyor. Bağlam kapısı adı verilen mekanizma da sorgu sırasında hangi bilgilerin çağrılacağını filtreleyerek tüm tablonun sürekli olarak yüksek hızlı belleğe yüklenmesini önlüyor. Böylece modelin büyük parametre kapasitesine rağmen pahalı HBM kullanımının sınırlanması ve toplam donanım mal iyetinin düşürülmesi amaçlanıyor.
MALİYET KARŞILAŞTIRMASI
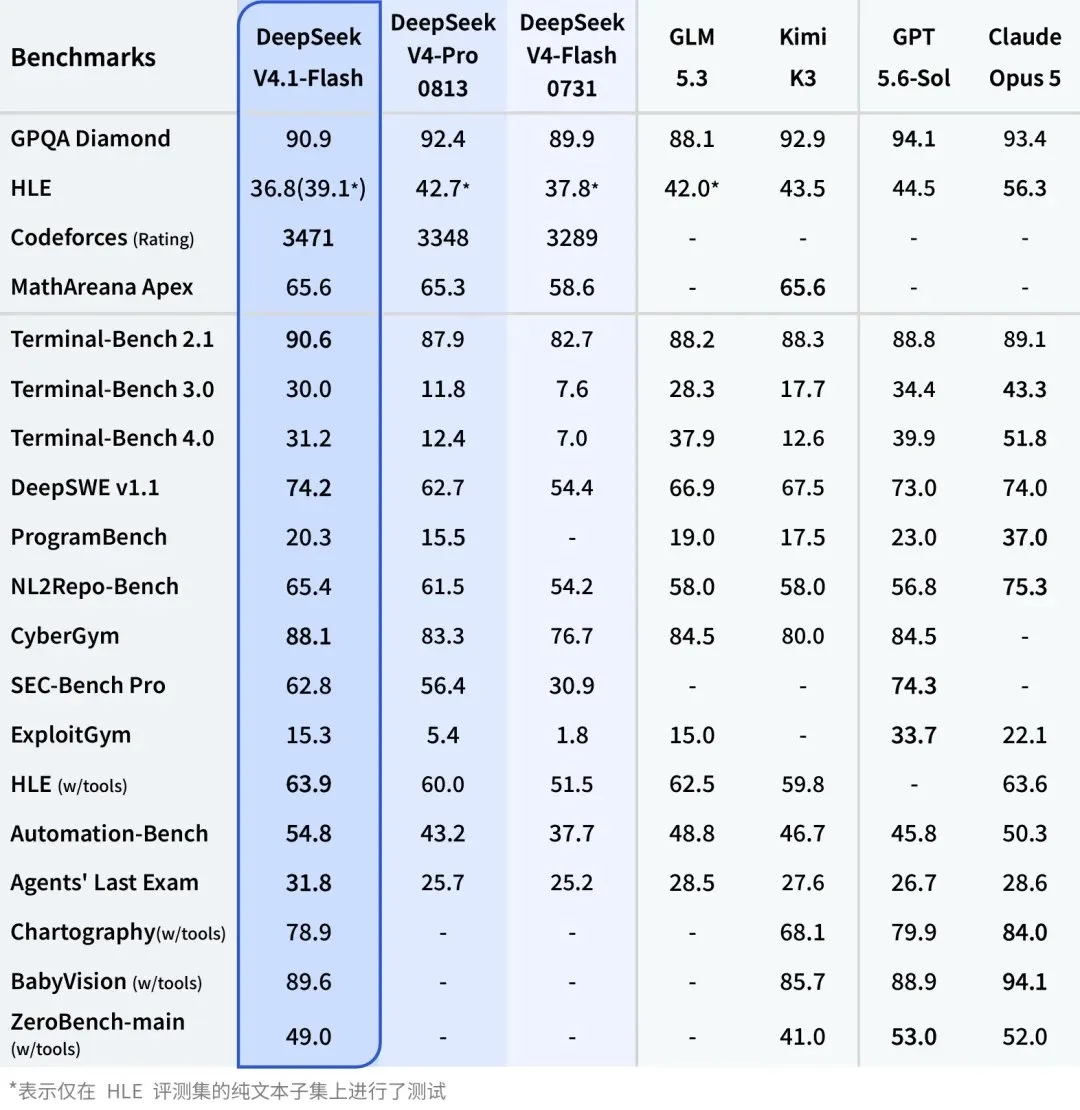
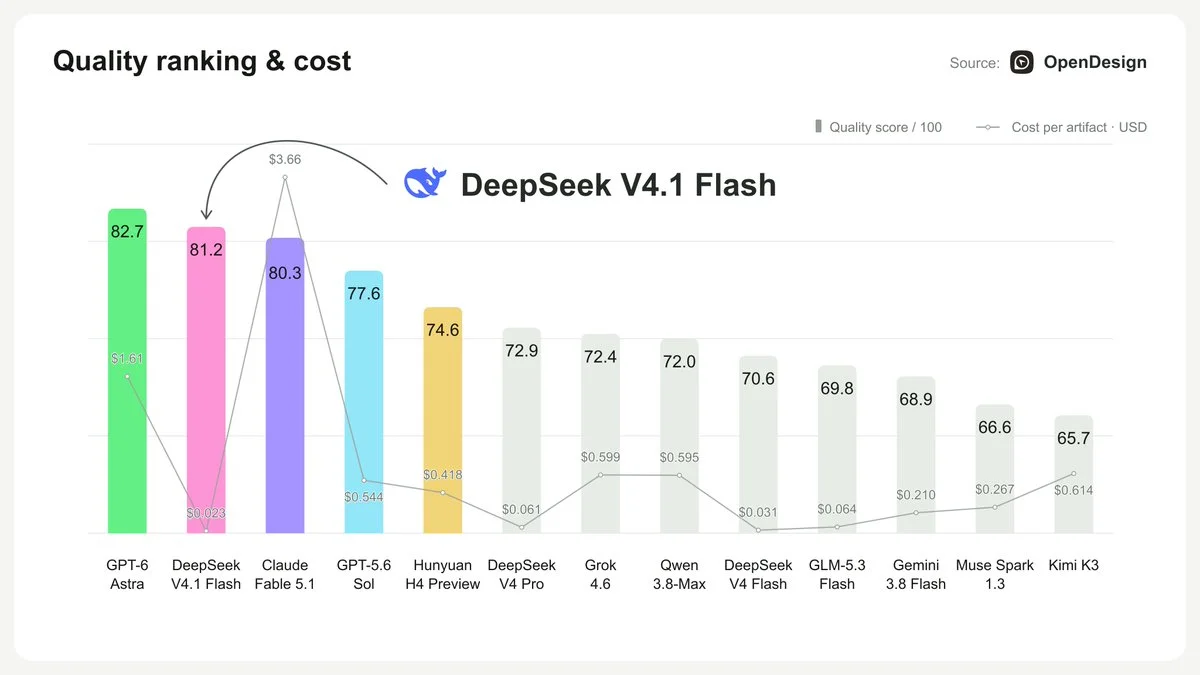
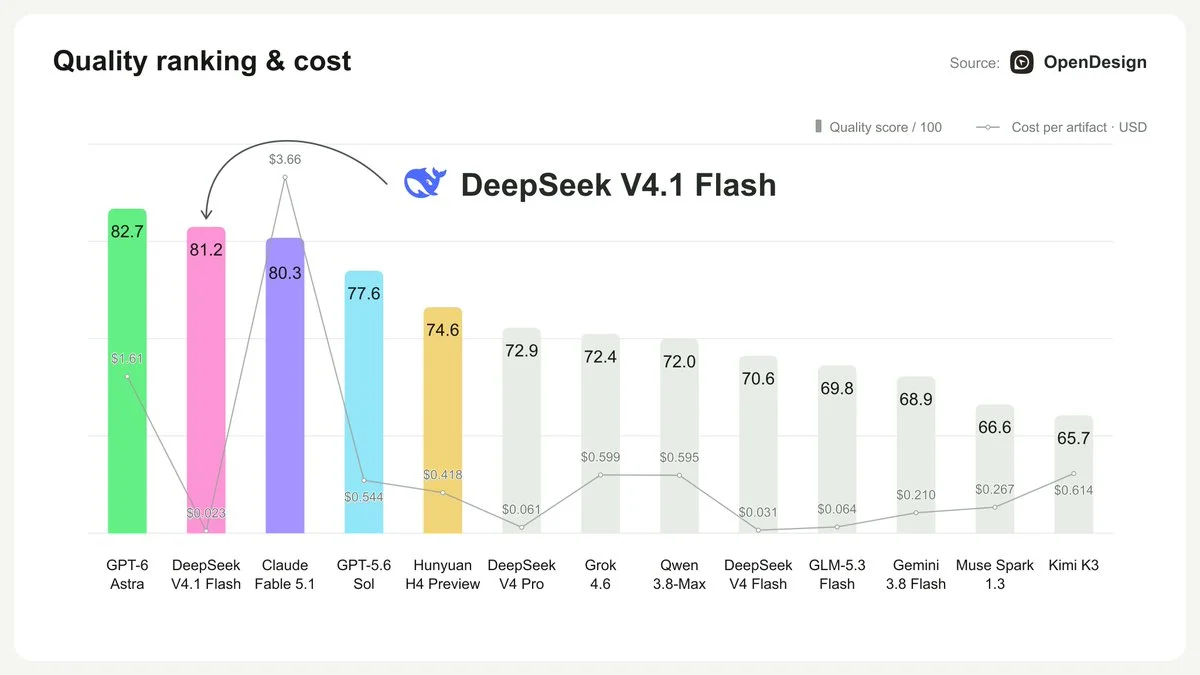
DeepSeek’in paylaştığı değerlendirmelere göre V4.1 Flash; kodlama, siber güvenlik ve tasarım testlerinde OpenAI’ın GPT-5.6 Sol ve Anthropic’in Claude Opus 5 modellerinin üzerinde sonuçlar elde ediyor. Şirket ayrıca modelin işlem maliyetinin GLM-5.3’e kıyasla yaklaşık dörtte bir, Kimi K3’e göre ise onda bir seviyesinde olduğunu belirtiyor. V4.1 Flash’ın OpenAI GPT-6 Astra’nın tasarım performansının yüzde 98’ine, maliyetinin yüzde 1,4’üyle ulaştığı da açıklanan karşılaştırmalar arasında yer alıyor. DeepSeek, bu mimariyle büyük dil modellerinde yüksek performans ile düşük bellek ve işlem maliyetini aynı sistem içinde birleştirmeyi hedefliyor.