
Türkiye kendi yapay zeka ‘EVREN’ini inşa ediyor
Savunma Sanayii Başkanlığı bünyesinde geliştirilen EVREN; veri, model ve hesaplama gücünü aynı platformda buluşturuyor. Katkı karşılığında kredi kazanılan sistem, şirketlerin, araştırmacıların ve girişimcilerin yapay zeka geliştirme altyapısına erişimini kolaylaştırmayı hedefliyor.

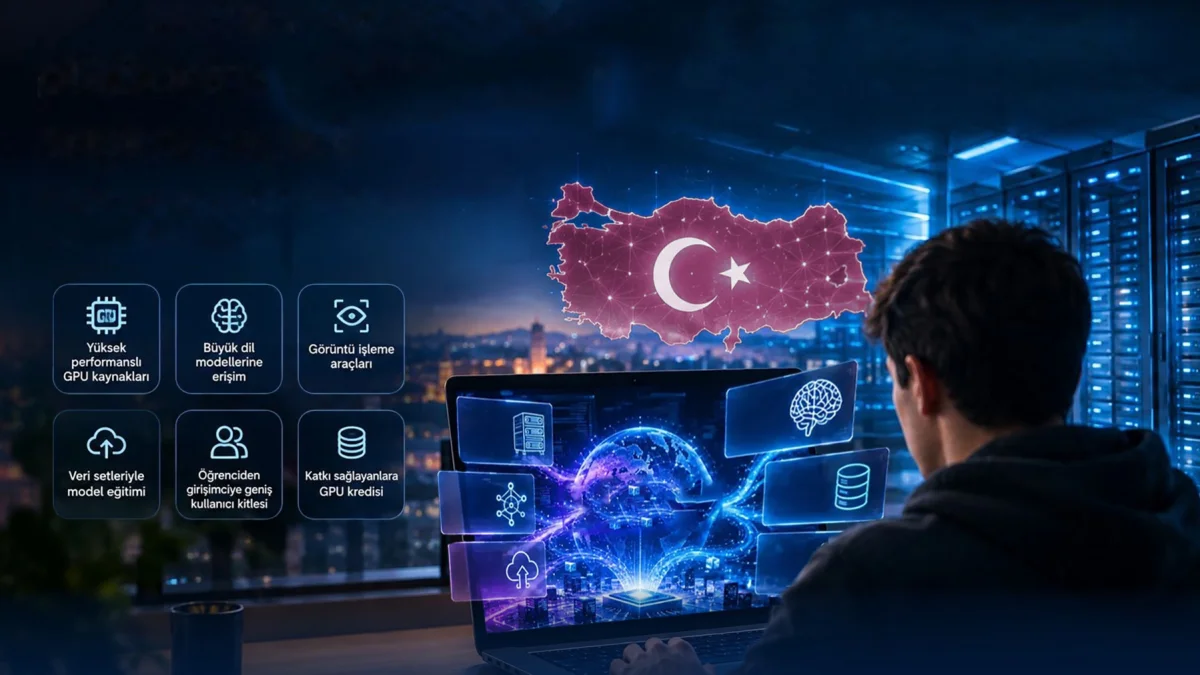
Türkiye’nin yapay zeka geliştirme kapasitesini artırmak amacıyla hazırlanan EVREN Yapay Zeka Platformu, veri hazırlamadan model eğitimine ve uygulamaya kadar uzanan süreçleri ortak bir altyapıda topluyor. Cumhurbaşkanlığı Savunma Sanayii Başkanlığı (SSB) bünyesinde geliştirilen platform; savunma sanayi firmaları, teknoloji şirketleri, üniversiteler, girişimciler ve öğrencilerin kullanımına sunuluyor. Sisteme evren.ssyz.org.tr adresinden e-Devlet kimlik doğrulamasıyla erişilebiliyor.
VERİDEN MODEL EĞİTİMİNE
EVREN, makina öğrenmesi modellerinin geliştirilmesi ve işletilmesini kapsayan MLOps altyapısıyla çalışıyor. Kullanıcılar veri hazırlama, etiketleme, model eğitimi, test, yayımlama ve operasyonel kullanım aşamalarını aynı platform üzerinden yürütebiliyor.
Ankara Üniversitesi Yapay Zeka Enstitüsü’nün 19 Haziran 2026 tarihli duyurusunda da platformun öğrencilerin bilimsel çalışmalarına açıldığı bildirildi. Böylece EVREN’in akademik kullanımı, eylül ayında kamuoyuna yansıyan duyurulardan önce başladı.
KATKIYA KARŞILIK KREDİ
Platformun işleyişinde kullanıcı katkısına dayalı bir kredi sistemi bulunuyor. Veri seti yükleyen veya veri etiketleyen kullanıcılar kredi kazanıyor; bu kredileri yüksek kapasiteli grafik işlemci kaynaklarına erişmek için kullanabiliyor.
Amaç, bu yöntemle araştırmacıların ve öğrencilerin maliyetli donanıma erişiminin kolaylaştırılması. Sistem, ortak veri birikiminin büyümesini ve yapay zeka projeleri için gereken hesaplama kaynaklarının kullanılmasını birlikte destekliyor.
11 MODELE ERİŞİM
SSB’den yapılan açıklamaya göre, EVREN’de 11 açık ağırlıklı büyük dil modelini kapsayan çıkarım hizmeti de devreye alındı. Bu hizmet, eğitilmiş modellerin kullanıcı taleplerine yanıt üretmesini sağlıyor. Uygulamalar, API üzerinden platforma bağlanabiliyor; anlık yanıt ve otomatik model yönlendirme özelliklerinden yararlanabiliyor. Açıklamada, kullanımı yaygınlaştırmak amacıyla 1 Kasım 2026’ya kadar API çağrılarının kredi bakiyesinden düşülmeden sınırsız sunulacağı belirtildi.
TÜRKİYE’DE VERİ İŞLEME
Başkanlığın açıklamasına göre istem, yanıt ve kullanım verileri Türkiye’deki GPU altyapısında işleniyor. Hassas verilerin yabancı bulut hizmetlerine aktarılmasının önlenmesi hedefleniyor. EVREN’in ilerleyen dönemde yerli büyük dil, görüntü ve ses modelleriyle genişletilmesi; hesaplama kapasitesinin dağıtık GPU yönetimiyle güçlendirilmesi de planlar arasında.
YERLİ BÜYÜK DİL MODELİ ÇALIŞMALARI
Türkiye’de büyük dil modeli (LLM) çalışmaları, sıfırdan model eğitimi ve mevcut modellerin Türkçe verilerle geliştirilmesi üzerinden ilerliyor. TÜBİTAK BİLGEM’in BİLGE ailesinde, resmi tanıtım sayfasına göre 1 milyar ve 9 milyar parametreli modeller sıfırdan eğitildi. 27 milyar parametreli sürüm, açık kaynak modeller üzerine Türkçe verilerle sürekli ön eğitim uygulanarak geliştirildi. 122 milyar parametreli modelin eğitimi ise sürüyor.
BİLGE’nin resmi internet sitesinde, model ailesinin henüz genel kullanıma açılmadığı belirtiliyor. T3 AI, T3 Vakfı ve Baykar işbirliğiyle geliştirilen çalışmalar arasında. Projenin paydaşlarından Türkiye Bilimler Akademisi’nin 27 Temmuz 2025 tarihli duyurusuna göre modelin beta sürümü, TEKNOFEST Sosyal platformuna entegre edildi. Kullanıcıların paylaşımlarına yanıt verebilen modelin Türkçenin yanı sıra farklı dillerde de çalıştığı bildirildi.
Özel sektörde Turkcell-LLM-7b-v1, şirketin yayımladığı model kartına göre Mistral tabanlı bir modelin Türkçe için geliştirilmiş sürümü. Eğitimde 5 milyar token içeren temizlenmiş Türkçe veri ve Türkçe talimat kümeleri kullanıldı. Model, Hugging Face üzerinden paylaşılıyor. Trendyol-LLM-8B-T1 ise Qwen3-8B üzerine, Trendyol’un hazırladığı Türkçe e-ticaret verileriyle geliştirilen 8 milyar parametreli bir sohbet modeli. Şirketin model kartında Türkçe akıl yürütme, özetleme, sınıflandırma ve ürün bilgilerinin çıkarılması kullanım alanları arasında sayılıyor.
Yorum yazmak için giriş yapın.
Henüz yorum yok. İlk yorumu siz yazın.