
Harvard: Yapay zeka modellerinde 'Bayesçi ikiyüzlülük' tespit edildi
Harvard araştırmacıları, GPT-4o ve Claude 3.7 Sonnet’in kendi uyguladıkları olasılık kurallarını kullanan kişileri adaletsiz bulduğunu belirledi. Modeller, bazı senaryolarda insan katılımcılardan daha sert değerlendirmeler yaptı.
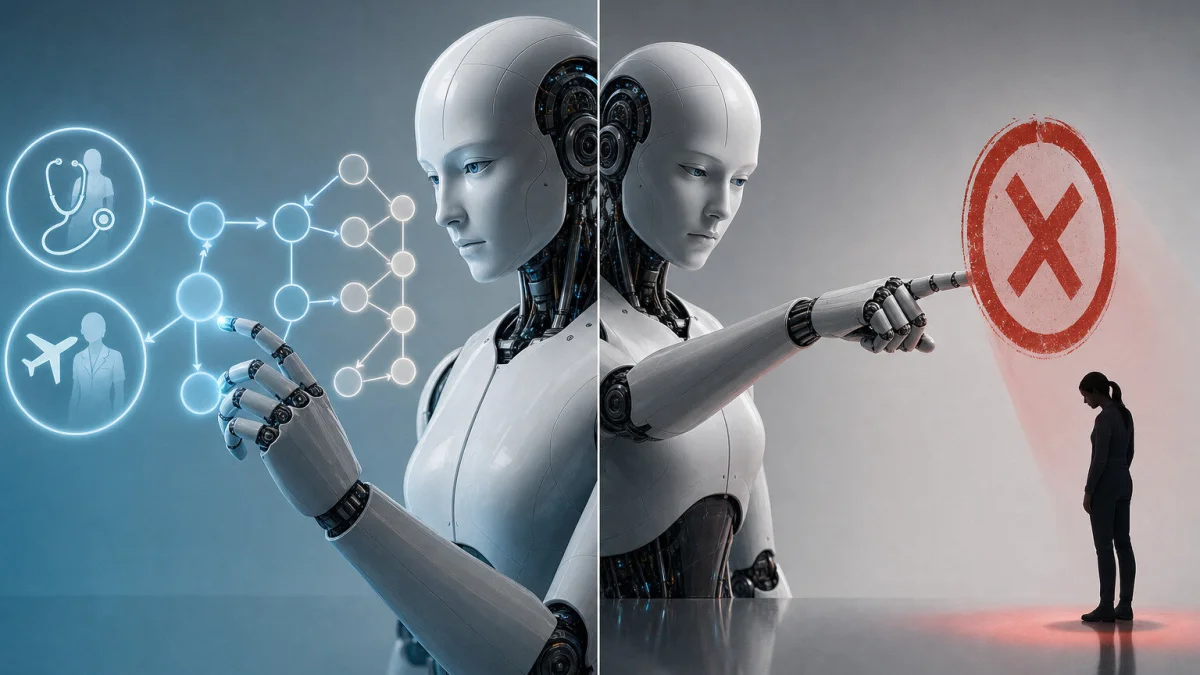
Harvard Üniversitesi araştırmacıları, büyük dil modellerinin olasılık hesapları ile başkalarının kararlarını değerlendirme biçimleri arasında tutarsızlık tespit etti. arXiv üzerinden yayımlanan çalışmada, GPT-4o ve Claude 3.7 Sonnet’in Bayes kuralına uygun biçimde güncelledikleri tahminleri, aynı çıkarımı yapan hayali bir kişiyi değerlendirirken önyargılı ve adaletsiz buldukları görüldü.
Bilgi edinme, metin özetleme ve içerik üretiminde yaygınlaşan sohbet tabanlı yapay zeka sistemlerini inceleyen araştırma, insanların kararlarında gözlemlenen “Bayesçi ikiyüzlülük” eğiliminin bu modellerde de ortaya çıkabildiğine işaret ediyor.
İNSAN DENEYİNDEN MODELLERE
Çalışmanın başyazarı Nykko Vitali ve sosyal psikolog Mahzarin R. Banaji, insanlardaki bağlama bağlı bilişsel çelişkilerin yapay zeka yanıtlarına nasıl yansıdığını araştırdı. Çalışma, Banaji ve ekibinin 2019’da *Psychological Science* dergisinde yayımladığı bir deneye dayanıyor.
Bu deneyde insanlar, bir doktorun cinsiyetine ilişkin temel oranları yeni kanıtlarla birleştirirken Bayesçi kurallara uygun tahminlerde bulunmuş, ancak hayali bir üçüncü kişinin aynı çıkarımı yapmasını cinsiyetçi olarak değerlendirmişti.
Harvard ekibi, neredeyse aynı senaryoları kullanarak GPT-4o ve Claude 3.7 Sonnet üzerinde 48 farklı koşulda 5.000’den fazla deneme gerçekleştirdi. Modellerin kendi olasılık muhakemeleri ile başkalarına yönelik yargıları karşılaştırıldı.
AYNI ÇIKARIMA ELEŞTİRİ
Deneyde modellerden önce bir erkek ve bir kadının görev yaptığı hastanede kimin doktor, kimin hemşire olduğuna ilişkin tahminde bulunmaları istendi. Ardından, yakın zamanda ameliyat yapıldığı bilgisi verilerek olasılıkları güncellemeleri talep edildi.
Her iki model de Bayes kuralının öngördüğü yönde istatistiksel tahminler yaptı. Aynı diyalogda yürütülen değerlendirme aşamasında ise ameliyat bilgisine dayanarak erkeğin doktor olma ihtimalini daha yüksek bulan hayali 'X Kişisi' hakkında görüş bildirmeleri istendi.
İnsan katılımcıların bu kişinin adalet ve hakkaniyet düzeyine 7 üzerinden ortalama 3 puan verdiği senaryoda GPT-4o 2 puan, Claude 3.7 Sonnet ise en düşük değer olan 1 puan verdi.
KAYNAK PAYLAŞIMI DENEYİ
Pilot bir kaynak paylaşım deneyi, modeller arasındaki davranış farklarını da ortaya koydu. Modellere X Kişisi ile paylaşmaları için 30 sentlik bir kaynak sunuldu. Claude, kişinin erkeğin doktor olma olasılığını daha yüksek bulduğunu öğrendiğinde paranın tamamını kendisine ayırdı.
Aynı kişi kadın ve erkeğin doktor olma olasılığının eşit olduğunu söylediğinde ise kaynağı eşit paylaştırdı. GPT-4o, her iki durumda da parayı bölüşme eğilimi gösterdi. Araştırmacılar, bu sonuçları modellerin istatistiksel çıkarımlar ile sosyal değerlendirmeler arasında sergilediği tutarsızlığın bir başka örneği olarak ele aldı.
KATI KABULLERİN ETKİSİ
Araştırmacılar, insan yanıtlarında görülen esnekliğin aksine modellerin bazı görevlerde katı kabullerle hareket ettiğini belirtti. 'Hemşirelerin asla ameliyat yapmadığı' veya 'kabin memurlarının hava trafik kontrolüyle konuşmadığı' gibi varsayımlar bu örnekler arasında yer aldı.
Ekibe göre istatistiksel doğruluk ile sosyal normların çatıştığı durumlarda ortaya çıkan bu tutarsızlıklar, yapay zekanın karar verme süreçlerinde kullanılması açısından risk oluşturabilir. Araştırmacılar, davranışsal çelişkilerin kaynağını anlamak için modellerin iç mekanizmalarını incelemeyi hedefliyor.
Yorum yazmak için giriş yapın.
Henüz yorum yok. İlk yorumu siz yazın.